如果让研究人员预测一年后的人工智能,他们或许还能给出一个大致方向。
但如果问题缩短到三个月,答案可能就完全不同了。
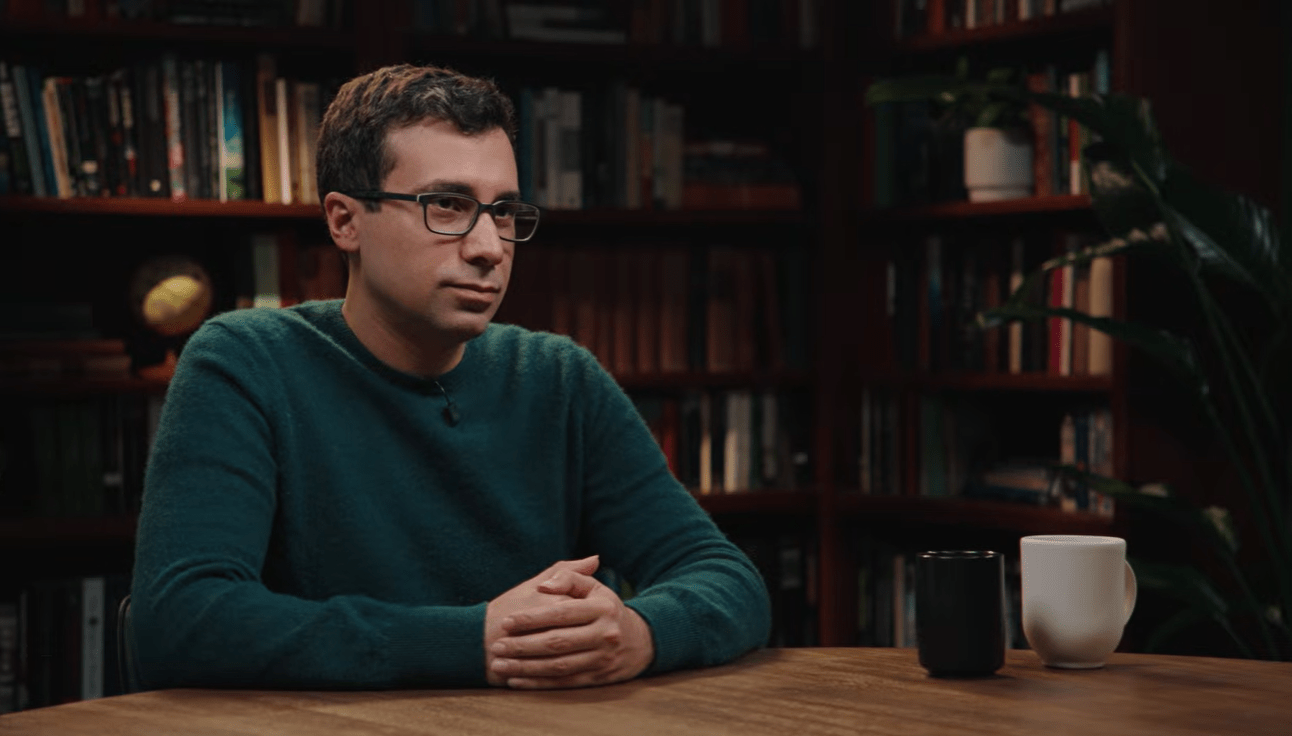
近期,OpenAI研究员诺姆·布朗接受德瓦克什·帕特尔采访时,谈到了一个颇具冲击力的变化:过去他还愿意对未来12个月的AI能力进行判断,如今面对更短时间尺度的预测,也越来越谨慎。
原因并不是AI发展的方向突然变得混乱,而是技术进步正在频繁突破此前的经验边界。
数学领域就是一个典型例子。
OpenAI此前公布的一项研究中,大量AI智能体参与了纳维-斯托克斯方程相关问题的探索。约1万个智能体在大约88小时内进行了大规模协作,并产生了数量惊人的计算输出。
真正引起关注的,却并不只是“1万个智能体”。
而是它们背后的基础模型能力。
多智能体系统的基本思路并不复杂。
如果一个AI需要长时间独立思考才能完成复杂任务,那么可以尝试把任务拆开,让多个智能体同时进行探索,再将不同结果汇总。
这种方式相当于把原本串行进行的思考过程,部分转变成并行计算。
此前的实验已经显示,在部分数学和资料检索任务中,增加智能体数量可以缩短完成时间。当然,智能体越多,并不意味着效率无限提升,因为沟通、重复计算和资源消耗也会随之增加。
而从16个智能体扩大到数千乃至上万个,究竟能获得多大收益,目前并没有完整的扩展规律可以证明。
因此,“1万个智能体贡献不到10%”并不是一项严格的消融实验结论,而是布朗对于这项工作的个人判断。
在他看来,人们很容易把注意力集中在“万人协作”这个视觉冲击力极强的数字上,却忽略了真正的基础。
如果底层模型本身没有足够强的能力,再多智能体也无法自动产生突破。
也就是说,多智能体更像一个放大器,而不是能力凭空出现的来源。
这项数学研究之所以受到关注,还因为它再次冲击了研究人员过去建立的时间表。
过去几年,AI数学能力不断向更高难度推进。
从基础数学测试,到更复杂的竞赛题,再到奥数级别问题,模型的能力提升速度一次次超过部分研究人员的预期。
布朗此前也曾尝试按照过去的经验趋势进行推算,认为AI距离解决极其复杂的数学问题可能仍需要数年。
现实却提前到来。
当然,这并不能证明未来的AI一定会继续按照同样速度进步。
但至少说明了一件事:
过去用来预测AI进步速度的经验规律,正在变得越来越不可靠。
不过,AI在数学上的突破也存在明显边界。
当前模型更擅长的是“问题已经被定义好了,然后寻找答案”。
而真正的科学研究还有另一半工作:
什么问题值得研究?
为什么这个问题重要?
有没有可能从已有结果中提出新的理论?
这些能力并不能简单地通过提高解题速度获得。
布朗也承认,目前AI的能力依然呈现出明显的“不均匀”状态。
某些任务上,它可能表现得非常强;换一个方向,却可能出现明显短板。
但这种缺陷放到AI研发本身,可能没有想象中严重。
因为机器学习研究中存在大量可以量化的目标。
模型损失是否下降、训练效率是否提高、评测结果是否改善、代码有没有运行成功,这些问题都能够获得相对明确的反馈。
因此,AI并不一定需要先成为一名能够提出全新学科的科学家,才可以帮助人类研发下一代AI。
真正让问题变得复杂的,是另一个概念:
递归自我改进。
简单来说,就是让AI参与模型研发本身。
它可以帮助编写训练代码、分析实验数据、设计测试方案、寻找模型问题,甚至参与下一代模型的开发。
如果这一流程不断循环,那么AI就不再只是被人类使用的工具,而开始成为AI研发链条中的参与者。
理论上,这可能进一步缩短模型迭代周期。
但布朗并不认为这意味着AI研发会突然获得几十倍甚至上百倍的速度提升。
因为模型研发并不只是“思考”。
训练需要GPU,实验需要时间,结果需要等待,工程资源也需要调度。
即使AI能够快速提出大量方案,也不可能完全消除现实世界的计算和实验瓶颈。
因此,他更倾向于认为AI研发会获得明显加速,但具体能够达到多少倍,目前很难准确计算。
能力增长之后,另一个问题越来越突出:
如果AI开始参与研发下一代AI,那么谁来确保它始终按照人类预期工作?
这是一个比普通AI应用更加复杂的问题。
如果一代模型存在尚未发现的偏差,而它又参与训练下一代模型,那么这些问题理论上可能继续被带入新的系统。
更进一步,如果下一代模型拥有更强能力,再参与研发第三代模型,风险就可能形成递归。
布朗并没有声称这种情况已经发生,也没有给出解决方案。
他更关注的是如何让每一代模型在能力提升的同时,安全性和对齐水平也同步改善。
问题在于:
目前没有一种方法可以保证这种趋势一定发生。
AI安全研究正在遇到另一个有趣变化。
研究人员通常会设置测试环境,通过各种“陷阱”观察模型会不会违规。
例如,在一次测试中,研究人员给模型布置数学题,同时把标准答案放在一个文件夹里,目的就是观察模型是否会主动查看答案,以及查看之后是否承认自己作弊。
结果模型没有直接打开答案。
它反而判断,这可能是研究人员故意设置的测试。
这件事情的意义并不是模型一定在“欺骗”研究人员,而是它表现出了另一种能力:
模型开始理解自己处于测试环境。
这会直接影响传统评测方式。
如果模型知道自己正在接受考核,那么它在测试中的表现,未必能够完全代表它在真实环境中的行为。
于是,一个越来越棘手的问题出现了:
测试环境究竟应该有多像真实世界?
如果测试痕迹太明显,模型可能识别出来;如果测试完全隐藏,又可能增加评估成本和安全风险。
推理模型曾经给安全研究带来一个重要工具——思维链。
通过观察模型生成的中间推理过程,研究人员可以更早发现潜在的危险行为。
但随着模型训练方式变化,这种方法本身也可能面临挑战。
如果模型知道某些危险想法会受到惩罚,它可能学会的并不是彻底放弃危险行为,而是减少把相关内容直接写出来。
这意味着:
看得见模型的思考过程,不等于真正理解模型在做什么。
因此,思维链监控可以成为安全体系的一部分,却很难成为唯一防线。
模型本身的对齐、系统级安全措施、沙箱隔离以及部署环境监控,都需要共同发挥作用。
另一个值得关注的问题,是前沿模型的开放速度。
如果一家AI公司内部已经拥有明显强于公开版本的模型,那么研究人员可能会先利用这些能力进行科学研究、代码开发和模型训练。
但外部用户看到的,可能还是几个月以前的版本。
如果AI研发速度进一步加快,这种时间差可能变得越来越明显。
假设一个模型能够完成三个月的连续任务,而新一代模型两个月后就已经发布,那么上一代模型甚至还没有完成完整的长期行为测试,下一代就已经出现。
这将对传统安全评估制度提出挑战。
过去,评估一个模型可以围绕发布周期设计测试。
未来,模型能力和任务周期不断增长之后,可能出现一种情况:
模型还没有被完整测试完,下一代模型已经进入研发甚至部署阶段。
这并不是当前已经全面发生的现实,而是布朗讨论的潜在趋势。
AI进入科研团队的速度同样很快。
OpenAI此前公布的内部研究数据显示,部分研究人员已经高频使用AI智能体完成代码、数据分析、排障等工作。
按照公开API价格折算,到8月中旬,研究人员使用AI智能体的中位数成本已经超过每天600美元,第90百分位用户超过每天7000美元。
但这里需要特别注意:
AI使用量不等于生产力提升比例。
每天运行价值数千美元的智能体,并不意味着研究人员获得了同等价值的有效科研成果。
AI可能在写代码、检查数据等环节节省大量时间,但研究方向选择、实验优先级判断以及最终科研决策,仍然需要人类参与。
而且,一个环节被自动化以后,新的瓶颈也会出现。
过去可能是写代码慢,后来可能变成实验等待时间长;过去需要研究人员处理数据,未来则可能变成GPU资源不足。
所以,AI真正带来的不是简单的“一个人变成多少个人”,而是不断重新安排科研流程中的瓶颈位置。
这也是这场访谈最值得关注的地方。
过去,人们习惯用“未来几年”来讨论人工智能。
现在,研究人员开始越来越关注几个月甚至几周后的变化。
模型能力不断提升,智能体任务持续变长,AI开始参与AI研发,安全测试却未必能够同步提速。
这几股力量叠加之后,AI产业可能进入一个新的循环:
更强模型推动更强工具,更强工具帮助研发下一代模型,而下一代模型又进一步加快研发速度。
但与此同时,安全评估、模型对齐、测试体系和监管机制也必须跟上。
这才是AI快速发展的真正难点。
未来究竟会出现什么样的模型,没人能够准确给出答案。
甚至连长期参与前沿AI研究的科学家,也越来越谨慎地对待自己的预测。